


条码下方那串可读字符(HRI,Human Readable Interpretation)常被认为是最不重要的部分——扫码枪读的是条和空,不是这串字。但在实际交付中,它是人工核对、批次复核与来料验收的第一道关口:字符缺失、字形被压扁、比条码还宽、压到条空上,任何一项都会被判为外观不合格。本文只讨论这串字符的打印问题,按「数据从哪来 → 对象怎么设 → 版面放不放得下 → 输出端有没有被替换」四层往下查。整体版式偏移与模板错位请参见《Brady Workstation 模板偏移与字体丢失排查》;条码本体等级不达标请参见《条码等级验证不达标的排查与校准指南》;二维码容量与模块尺寸请参见《二维码与DataMatrix容量超限与纠错设置排查》。
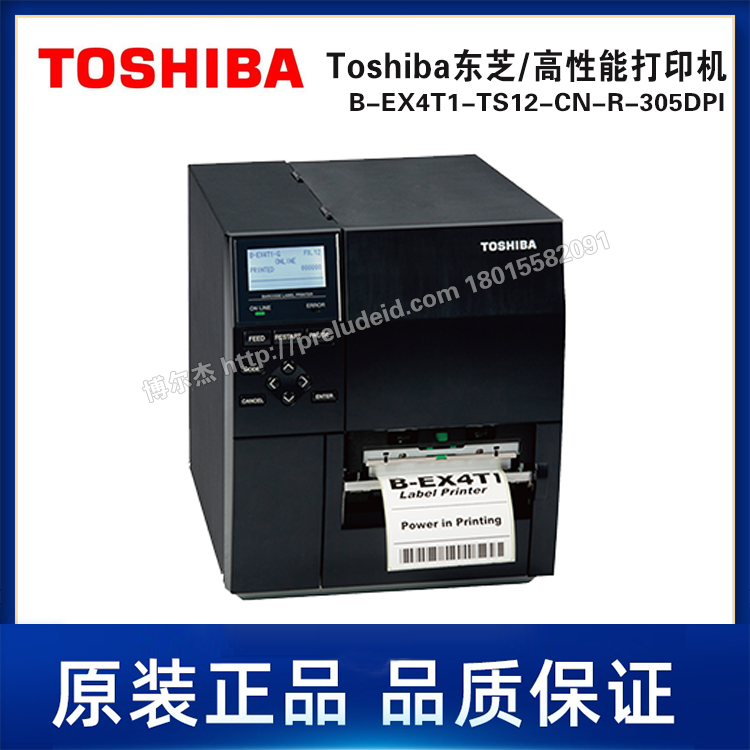
图 1 TOSHIBA B-EX4T1-TS12-CN-R 305dpi 工业标签打印机,300 dpi 级机器上按点定义的字号与按磅定义的字号会呈现不同的比例
一、先把四类现象分开,否则一定反复返工
「字不对」是一个笼统描述,落到可操作的层面只有四类,成因分属不同层:
- 缺字:整串不出现、只出现一部分、或只缺最后一位。多与 HRI 开关、字体未下发、对象被覆盖有关。
- 字形失真:横向压扁、纵向拉长、笔画粘连,数字 8 与 6 分不清。多与缩放方式、字体选择、打印浓度有关。
- 宽度不匹配:字符串比条码宽、比条码窄很多、或左右不齐平。多与字号单位、全角字符、自动适应宽度有关。
- 位置错乱:压到条空上、贴到标签边缘被切掉、跑到条码上方、整体颠倒。多与偏移参数、裁切区、旋转设置有关。
判断顺序建议固定为四步:先看预览与实打的差异(差异只在实打 → 输出层),再看换一台同型号机器是否复现(只在某台 → 输出层或驱动),再看换一种码制是否复现(只在某码制 → 数据层或码制约定),最后看字符是否跟着条码一起缩放(一起变 → 对象层或版面层)。这四步做完,问题基本已经定位到某一层,不必再全域试错。
二、可读字符不属于符号本体,但受三条硬约束
HRI 不参与解码,ISO/IEC 15416 的扫描反射率分级也不直接测量它。这容易让人误以为它可以随便摆,实际有三条不能破的约束:
- 不得侵占静区。Code 128 两侧各需 10X 的空白(X 为窄条宽度);EAN-13 左侧留 11 个模块、右侧留 7 个模块。字符探进静区,等于人为缩短静区,扫不出时很少有人会想到是字造成的。
- 不得压条空。字符顶到条码下沿,或与 EAN/UPC 的保护条重叠,会在符号下缘制造额外的反射变化,影响缺陷与边缘判定。肉眼看着也许只是「挨得近」,校验仪上就是掉级。
- 宽度与符号一致。行业惯例是字符串左右与符号左右齐平,EAN/UPC 按分组对齐。宽出一截的字符会迫使贴标空间变大,也常被客户直接判外观不合格。
三、第一层 数据层:打出来的字和扫出来的码不是同一串
这一层最隐蔽,因为扫码结果是对的,只是印在纸上的字错了。逐项核对:
- 校验位。EAN-13 与 UPC-A 的最后一位由前面各位算出。若软件里手工填满了 13 位,而校验位开关又处于打开状态,会出现「编码用手工值、字符按计算值渲染」,两者差一位。表现为字符与扫码结果永远差最后一位。
- 前后缀。Code 128 的 FNC1、Code 39 的起止符、以及业务系统追加的分隔符,可能在编码时加入而在字符里不显示,或反过来。核对方法是读一次码,把读到的字符串与屏幕上的 HRI 逐字符比对,不要只看长度。
- 字符集边界。标准 Code 39 只有 43 个字符(A–Z、0–9、空格与 - . $ / + %),没有小写字母。软件把含小写的字段编成 Code 39 时通常会转成大写或替换,HRI 若仍按原样打印,肉眼看的是小写、扫出来的是大写。
- 全角数字。中文输入法下的全角 012 宽度约为半角的两倍。编码阶段常被丢弃或替换成问号,HRI 却照样印出全角字,于是出现「字比码宽」「字和码不一致」两种症状叠加。
- 字段截断。业务系统字段超长时,软件可能按对象可容纳长度截断编码,但 HRI 仍按原字段渲染,结果是字符比码长、尾部多出几位。
四、第二层 对象层:开关、位置、字体、字号四组参数
条码对象属性里与 HRI 相关的一般只有四组,按顺序核对最快:
- 显示开关。多数软件把它做成三态:不显示、显示在下方、显示在上方。复制对象、切换码制、套用样式时这一项可能被静默重置,是「突然没字了」的第一嫌疑。
- 位置与偏移。位置决定字符在条码上方还是下方;偏移决定字符基线与条码下沿的距离。偏移设成 0 时字符常常顶到条空,设得过大又会挤占下一行内容或被标签边界裁掉。
- 字体。优先用打印机内置字体或规范指定字体。EAN/UPC 的 HRI 惯例使用 OCR-B(字体标准见 ISO 1073-2),它按光学识别设计,笔画粗细与字宽比例固定。换成系统里好看的矢量字体通常带来两个新问题:目标机器没有该字体,以及细笔画在 203 dpi 下直接糊掉。
- 字号与缩放方式。缩放方式一般有三种:固定字号、随条码缩放、自动适应宽度。选「自动适应宽度」时,条码一变窄,软件就把字符横向压缩来凑宽度——这是字形失真最常见的来源,不是字体坏了,换字体也修不好。
五、比例失真的根因:单位混用
一份模板里同时存在三种长度单位:点(dot,打印机的最小成像单元)、毫米、磅(pt,1 pt = 1/72 英寸,约 0.3528 mm)。麻烦在于条码的窄条宽度通常按「点」定义(例如 2 dots),而字号按「磅」定义,两者绑在不同尺度上:
- 203 dpi 时 1 dot 约 0.125 mm;300 dpi 时约 0.0847 mm;600 dpi 时约 0.0423 mm。
- 同一份模板从 203 dpi 换到 300 dpi:按点定义的条码物理宽度缩小约 32%,按磅定义的字号物理尺寸不变,于是字相对条码变大了。
- 反过来从 300 dpi 换到 203 dpi:条码变宽、字号不变,字相对变小,甚至超出预留高度而被裁掉下半截。
处理原则只有一条:字号与条码宽度的单位要么都用物理长度,要么都用点,不要一混到底。若软件只允许按磅设字号,就在换 dpi 后按比例重算一次,并在样张上量实际字高,而不是凭屏幕预览判断。
可操作的取值范围:HRI 字高取条高的 1/5 到 1/3,字符串总宽不超过符号宽度。两条同时满足时,比例在视觉上基本正确,也不容易侵占静区。
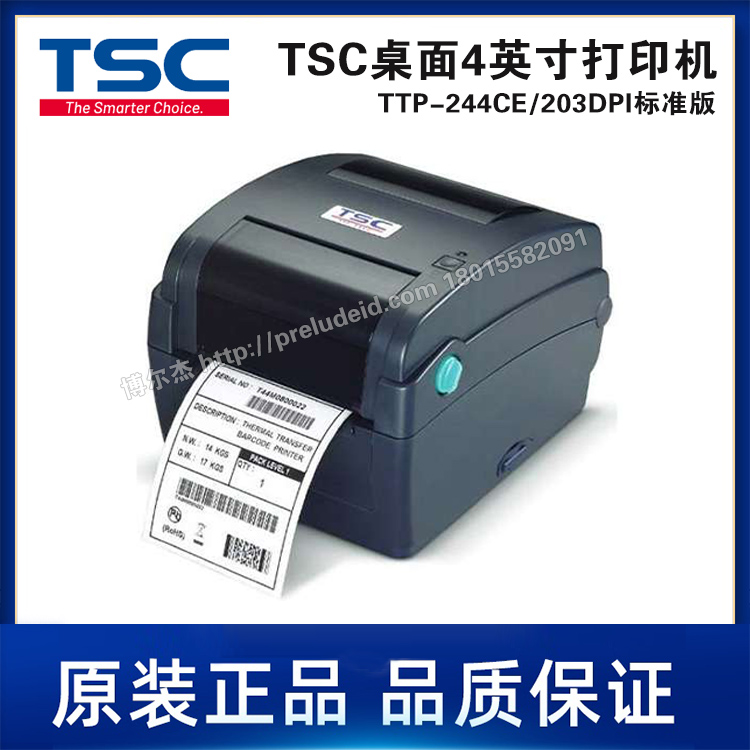
图 2 TSC TTP-244CE 203dpi 桌面标签打印机,203 dpi 下 1 dot 约 0.125 mm,字号换算需按此重算
六、第三层 版面层:放不下、被裁掉、被盖住
- 可用宽度不够。25×8 这类小规格标签,Code 128 编码 12 位数字后符号本身已接近占满宽度,再排 HRI 只能压缩或溢出。正确做法是缩短数据、换更紧凑的码制或提高一档分辨率,而不是把字号压到读不出。
- 被裁切。对象超出标签可打印区时,超出部分被裁掉,表现为「字的下半截没了」。把对象临时拖到版面中央单独打一张,即可区分是裁切还是字体问题。
- 被覆盖。图层顺序在后的白色底色块、白色矩形对象压在上面,会把 HRI 盖住。表现为预览里看得到、打印出来没有——预览按对象顺序渲染,打印按图层顺序覆盖。
- 旋转与方向。条码整体旋转 90° 后,HRI 的方向参数可能仍是水平,字就横躺在条码旁边;镜像打印时字符也会跟着镜像,读起来是反的。

图 3 Brady B-423 25×8 mm 小规格聚酯标签,窄幅标签上可读字符与符号争宽度是高频冲突点
七、第四层 输出层:字体没送到、缩放被改、指令被覆盖
- TrueType 没有被送到打印机。热敏机内置的是点阵或笔画字体,TrueType 需要随作业下发或事先下载到机器。软件里「以图形方式打印文本」关闭时,机器收到的是「用某字体打印某字符串」的指令,机器没有该字体就替换成内置字体,或直接丢弃,于是缺字或字形突变。
- 驱动做了缩放。驱动里的「缩放以适应页面」「按百分比缩放」会让整页等比变化。条码与字符一起变,比例看着对,但静区与边距被改,扫读余量下降。
- 指令参数覆盖。ZPL 的 ^BC 指令参数里直接控制 HRI:是否打印解读行、解读行是否置于条码上方。设计软件里设了显示,模板最终被指令覆盖成不打印,就会整串不出。核对办法是抓实际下发的指令,看这两个参数,而不是只看软件界面。
- 浓度与胶辊。浓度过高会让笔画粘连,细笔画数字糊成一团;浓度过低会让下半截笔画断开。这属于打印质量范畴,与字形设置无关,但肉眼常被误判成字体问题,白换几轮字体。
八、按码制分别核对
- Code 128:HRI 不含起止符与 FNC;若使用 FNC1(GS1-128),HRI 惯例用括号表示应用标识符。字符集覆盖 ASCII,扩展字符依赖 FNC4,部分老机器对 FNC4 支持不完整,会出现「码对字错」。
- Code 39:HRI 是否显示 * 起止符要与上下游约定一致,一侧显示一侧不显示就会在人工核对时对不上。宽窄比 2:1 到 3:1,比例改动会影响整体宽度,字符对齐随之变化。
- EAN-13 / UPC-A:HRI 按分组排列,首位在左保护条外侧,左右各 6 位分组,保护条下延作为分隔,字体按 OCR-B。分组错位是所有外观不合格项里最常见的一类。
- 二维码(QR / Data Matrix):符号本体没有 HRI 位,可读字符是另加的文字对象。它与符号的位置关系要单独摆,并注意别把它放进静区范围内。
九、八步校正顺序
- 扫码比对:读一次码,逐字符比对 HRI,确认数据层一致。
- 查开关:确认 HRI 显示状态与位置,排除被关闭或被置顶。
- 查单位:确认字号单位与条码宽度单位,按当前 dpi 重算字号。
- 查缩放:关闭「自动适应宽度」,用固定字号重打一张。
- 查裁切与覆盖:对象移到版面中央,单独打一张。
- 查字体可用性:换成打印机内置字体或 OCR-B 再看是否复现。
- 查指令:抓实际下发指令,核对 HRI 相关参数。
- 定稿留档:把最终字号、字体、偏移、目标 dpi 写进模板说明,随模板一起归档。
十、验收与留档
验收分两步。第一步肉眼看:字符完整、字形不变形、左右与符号齐平、不压条空、不侵占静区、不越出标签边界。第二步抽测:每小时或每批抽 3 到 5 张,用扫码枪读一次并与 HRI 比对。条码本体的等级仍按 ISO/IEC 15416 用校验仪测,两者互不替代——HRI 印得再漂亮,也不能把 C 级条码救成 A 级;反过来,等级合格的标签,若字符缺位,人工核对环节照样会出错。
常见问题
1. 把可读字符关掉,会影响扫码吗?
不影响解码。扫码枪读的是条空组合,HRI 不参与。但如果标签要经过人工记录、批次复核或客户验收,缺字符通常直接判外观不合格,所以只有在全自动产线、且上下游明确约定不要字符时才建议关闭。
2. 预览里有字,打出来没有,最可能是什么原因?
三处优先查:一是图层顺序,白色底块压在上面;二是字体没有下发到机器,被内置字体替换后丢弃;三是下发的指令里解读行参数被置为不打印。判断办法是换一台同型号机器打同一模板,两台都缺是模板或指令问题,只有一台缺是那台机器的字体或固件问题。
3. 字被横向压扁了,换字体有用吗?
多数情况没用。压扁通常来自「自动适应宽度」或「随条码缩放」,是软件在压缩字宽以凑齐符号宽度。先关掉自动缩放,改用固定字号;换字体只在字形本身设计过窄或过宽、且比例已正确时才有效。
4. 203 dpi 的机器上,可读字符最小能打多小?
203 dpi 下 1 dot 约 0.125 mm,笔画要靠点堆出来。实践经验是字高不低于 2 mm 比较稳妥,低于 1.5 mm 时数字 8、6、9 容易粘连,需实打样张确认。具体能到多小取决于字体笔画粗细与浓度,不要凭参数表推定,一定打样看。
5. EAN-13 的字符能不能只打后 6 位?
不建议。EAN-13 的 HRI 惯例是完整分组显示:首位在左保护条外侧,左右各 6 位分组,与保护条下延的分隔位置对应。只打部分位会让操作员无法完整核对,客户抽检时也常按分组是否规范判定。确有空间限制时,应先考虑降低放大系数或改用更窄的标签,而不是省字符。
6. 换成 300 dpi 的机器,字号要不要改?
要。如果字号按磅定义、条码按点定义,换 dpi 后两者相对比例会变。经验算法是按 dpi 比例反算:从 203 换到 300,条码物理宽度缩小约 32%,若希望字符与符号的视觉比例不变,字号也应同比例缩小。改完必须打样量实际字高,不能只看预览。
7. 条码下面的字为什么被切成两行?
多数软件的 HRI 对象默认不换行,出现两行通常说明字符被放进了独立文本对象、且该对象启用了自动换行或宽度固定。若 HRI 是条码对象的组成部分,则多半是字符超出对象宽度后被渲染成两段。处理办法是把 HRI 交回条码对象管理,或把文本对象的宽度设为自动。
8. 全角数字为什么会让条码变宽或者字对不上?
全角字符在多数编码器里不属于标准字符集,可能被丢弃、替换成问号,或被按双字节处理。编码结果与屏幕显示就此分叉:码里少了一位,字里还是全角。核对方法是扫码后逐字符比对,并把输入源统一成半角数字。
9. 同一模板两台机器,一台清楚一台糊,是字体问题吗?
先排除浓度与胶辊,再看字体。同模板两台机器字迹差异,常见原因是其中一台用了内置字体、另一台用了下发字体,或两台浓度设置不同导致笔画粘连。把两台机器的浓度、速度、字体来源三项对齐后再比较,才能判断是不是字体本身的问题。
10. 可读字符印得好,等于条码合格吗?
不等于。HRI 是给人看的,条码等级是给机器读的,两者是两套判定体系。ISO/IEC 15416 评的是符号的对比度、调制比、缺陷、可解码性等指标,与字符是否清晰无关。交付前应分别验收:字符按外观标准看,符号按等级标准测。
相关阅读:Brady Workstation 模板偏移与字体丢失排查 条码等级验证不达标的排查与校准指南 二维码与DataMatrix容量超限与纠错设置排查